Gavel은 얼린 언어 모델의 중간층 신호를 읽어, 방대한 스킬 라이브러리에서 후보를 좁히는 연구예요. 같은 Qwen3-32B도 스킬 전달 구조에 따라 Skill-Use 정확 스킬 트리거율이 .011에서 .909로 달라졌다고 보고해요.
스킬이 늘수록 에이전트에게 필요한 일은 “더 좋은 모델을 고르는 일”만이 아니에요. 지금 받은 요청에 맞는 스킬을 찾아, 필요할 때만 불러오는 전달 구조가 함께 중요해져요. 코난쌤의 Gavel 논문 정리는 이 문제를 얼린 모델 내부의 신호로 풀어 보려는 연구를 정리해요.
스킬이 많아질수록, 목록을 먼저 보여 주는 방식은 무거워져요
논문은 두 가지 익숙한 선택을 비교해요. 하나는 스킬 이름과 설명을 컨텍스트에 미리 싣는 progressive disclosure예요. 다른 하나는 외부 임베더와 리랭커가 후보를 찾는 retrieve-and-rerank예요. 전자는 스킬 메타데이터가 컨텍스트를 차지하고, 후자는 에이전트 바깥의 모델이 선택을 맡는다는 조건이 있어요.
| 전달 구조 | 스킬을 고르는 위치 | 이 연구가 짚은 조건 |
|---|---|---|
| Progressive disclosure | 프롬프트 안의 스킬 목록 | 스킬 메타데이터가 컨텍스트를 차지하고, 라이브러리가 커지면 선택이 어려워질 수 있어요. |
| Retrieve-and-rerank | 외부 검색·재정렬 모델 | 컨텍스트는 덜 복잡해지지만, 에이전트가 직접 선택하는 범위는 줄어들 수 있어요. |
| Gavel | 얼린 백본의 순전파 중간층 | 모델 내부 신호로 전체 후보를 훑고, 좁힌 후보를 다시 판단해요. |
Gavel은 두 번 보고, 한 번 고르는 구조예요
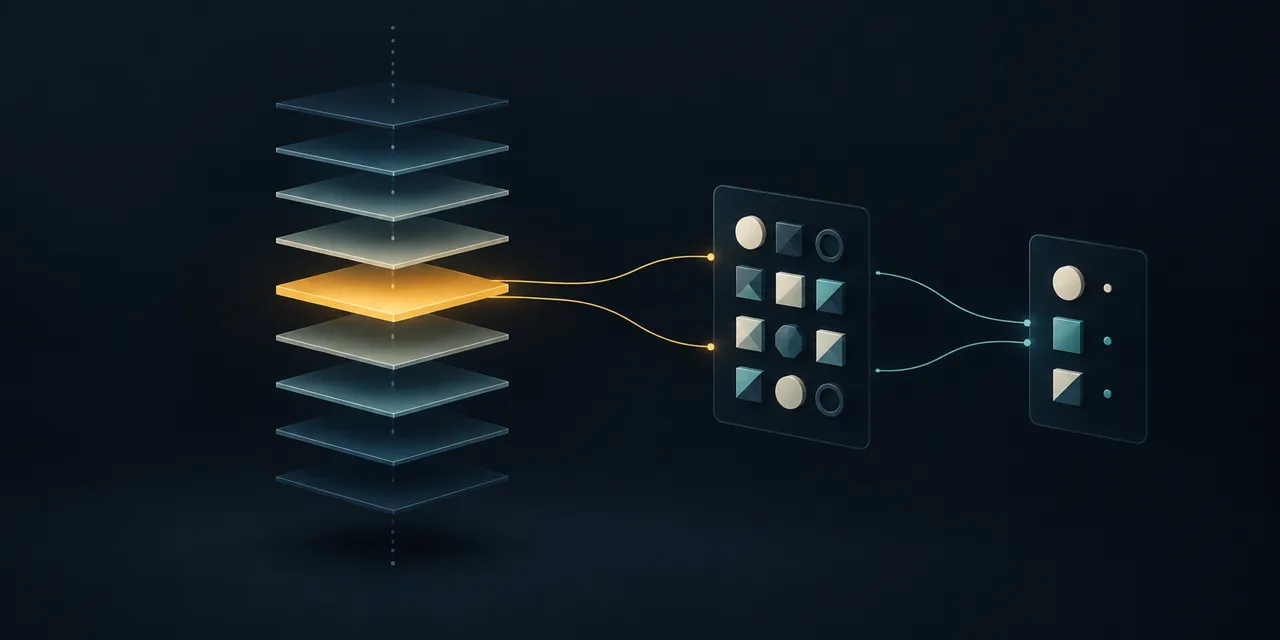
Gavel은 Glance와 Verdict 두 단계로 움직여요. Glance는 모델 중간층에서 읽은 신호와 스킬별 키 뱅크를 비교해 전체 라이브러리를 빠르게 훑어요. Verdict는 그 후보만 다시 보며, 모델의 가능도와 yes/no 판단 신호를 함께 반영해요. Qwen3-32B에서는 64개 블록 가운데 45번째 블록을 사용했고, 학습하는 것은 선형 사영 두 개와 7.9M 파라미터뿐이라고 보고해요.
얼린 백본의 중간층 신호를 이용해 전체 스킬 후보를 좁힌 뒤, 남은 후보를 다시 평가하는 구조예요.
이 구조는 새 스킬을 넣을 때도 눈여겨볼 만해요. 논문은 스킬을 설치할 때 순전파 한 번으로 키 뱅크를 만들고, ε-cover 압축으로 뱅크를 약 8.5배 줄일 수 있다고 설명해요. 학습을 다시 하지 않아도 새 스킬을 후보군에 넣을 수 있다는 뜻이에요.
같은 모델도 스킬 전달 구조에 따라 다른 결과를 보였어요
논문이 보고한 Skill-Use 하네스 결과에서, 같은 Qwen3-32B는 progressive disclosure만 사용할 때 정확 스킬 트리거율이 .011이었고 Gavel을 붙였을 때는 .909였어요. 외부 1.2B~16B 검색 파이프라인과 비교한 공개 벤치마크에서도 SkillRet +3.8pt, SRA-Bench +13.4pt, SkillTraj 최대 +21.9pt를 보고해요.
잘못 고른 스킬은 스킬이 없을 때보다 성능을 더 떨어뜨릴 수 있어요.
코난쌤 블로그 정리, 2026-09-16 확인
여기서 수치는 연구팀의 v1 프리프린트 결과예요. 재현과 후속 검증 전까지 확정치로 받아들이기보다, 스킬 선택 구조가 성능에 얼마나 큰 영향을 줄 수 있는지 살피는 관찰값으로 읽는 편이 안전해요.
오늘의 배울 점과 다음 적용
Editor_K의 해석 · 스킬을 많이 모으는 일보다, 요청이 들어왔을 때 “지금 이 스킬이 필요한가”와 “어떤 설명만 먼저 보여 줄까”를 분리해 설계하는 일이 먼저예요. 다음에 스킬 목록을 정리할 때는 이름·설명이 너무 길어져 컨텍스트를 차지하지 않는지, 비슷한 스킬이 같은 요청에 함께 뜨지 않는지 작은 요청으로 점검해볼 수 있어요.
적용 전에는 세 가지를 확인해요. 공개 API만 쓰는 모델이라면 내부 forward 상태에 접근할 수 없어서 Gavel 방식을 그대로 적용하기 어려워요. 또한 스킬이 필요 없는 순간을 가르는 gate는 별도 과제로 남아 있어요. 마지막으로 프리프린트 수치와 실제 운영 환경의 결과를 같은 것으로 보지 않아요.
한계는 구조의 일부로 남겨야 해요
Gavel은 백본의 forward 상태를 읽을 수 있는 환경을 전제로 해요. 그래서 API만 제공하는 모델에 그대로 붙이기 어렵고, 스킬을 아예 불러오지 않아야 하는 순간을 판단하는 gate도 별도 학습이 필요해요. 이 연구는 “어떤 상황에서도 가장 좋은 스킬 선택기”를 확정한 결과가 아니라, 모델 선택과 하네스 설계를 함께 살펴야 한다는 연구 신호로 보는 편이 맞아요.
출처와 시각자료
본문 출처
- 코난쌤 블로그, 「LLM 에이전트가 스킬을 잘 고르는 법: Gavel 논문 정리」 · 2026-09-16 확인
- Chen, Ruishuo 외, “The Router Within: Eliciting Native Skill Routing from a Frozen LLM”, arXiv:2609.15982 · v1 제출일 2026-09-14, 2026-09-16 확인
시각자료 출처
- 대표 이미지와 본문 보조 이미지는 gpt-image-2로 2026-09-16 생성한 AI 생성 이미지예요. 실제 제품 화면·실험 결과·논문 그림을 재현하지 않은 개념 일러스트로 사용했어요.
- 표와 다이어그램은 Editor_K가 작성했어요. 수치와 구조의 근거는 위 논문과 블로그 정리이며, 다이어그램은 읽기 쉽게 재구성했어요.
forum 토론 및 피드백 0
아직 작성된 피드백이 없습니다. 첫 번째 생각을 남겨보세요!