AI 에이전트가 화면에서 “저장 완료”를 보고했는데 데이터베이스에는 엉뚱한 값이 남는 ‘조용한 실패’를 정량화한 ERPBench(arXiv:2609.17885) 결과가 공개됐어요. 저장 발동 68%에 DB 정답률 9%를 기록한 모델 사례는, AI의 성공 보고를 화면이 아니라 결과 상태에서 확인해야 하는 이유를 숫자로 보여 줘요.
화면을 직접 조작하는 AI 에이전트(CUA, 컴퓨터 사용 에이전트)의 성공을 어디서 판정할지가 중요해졌어요. 오픈소스 ERP(전사 자원 관리 시스템)에서 스크린샷만 보고 업무를 수행한 뒤, 성공 여부를 화면이 아니라 데이터베이스의 최종 값으로 채점하는 벤치마크 ERPBench가 나온 것이 이번에 확인한 변화예요. 코난쌤 블로그의 ERPBench 정리 글을 1차 근거로 읽고, 원 논문(arXiv:2609.17885)과 함께 대조했어요. 이 글에서는 벤치마크가 어떻게 채점하는지, 어떤 숫자가 나왔는지, 업무 자동화에 붙일 때 무엇을 설계해야 하는지까지 다룰게요.
화면이 아니라 DB에서 채점하는 벤치마크
ERPBench의 접근은 단순해요. 에이전트에게 셀프호스팅한 오픈소스 ERP인 ERPNext의 화면을 스크린샷 1280×720으로만 보여 주고, 과제 수행 뒤 성공 판정을 화면이 아니라 최종 DB 필드 값으로 하는 거예요. 채점에는 ERPNext가 공개 문서로 제공하는 표준 웹 인터페이스인 Frappe REST API를 사용해요. 재현 불가능한 독점 플랫폼 벤치마크와 달리 전부 공개 구성이라 연구자가 같은 환경을 직접 돌려 볼 수 있다는 점도 특징이에요.
DB 레벨 채점이 왜 다른지는 “채점기가 최종 값을 어디서 읽는지”를 보면 명확해져요. 아래는 그 확인 위치를 보여 주는 설명용 예시예요. Frappe REST API는 ERPNext 공개 문서에 문서화된 표준 인터페이스고, 실제 서버 주소와 레코드 ID는 자리표시자로 뒀어요. 응답의 data 필드에 담긴 최종 값(금액·수량·상태 등)을 과제의 정답 값과 대조해 성공을 판정하는 게 DB 레벨 채점의 핵심이에요. 아래 응답 구조는 문서화된 인터페이스를 설명하기 위한 예시이지 실제 응답 값이 아니에요.
# 설명용 예시 — DB 레벨 채점이 최종 값을 확인하는 위치
# Frappe REST API: ERPNext 공개 문서에 문서화된 표준 REST 인터페이스
# 서버 주소·레코드 ID는 자리표시자예요. 확인일: 2026-09-19

curl -b <SESSION_COOKIE> \
  "https://<ERP_HOST>/api/resource/Sales%20Invoice/<RECORD_ID>" \
  -H "Accept: application/json"

# 조회 응답 구조(설명용 예시 — 실제 응답 값이 아니에요):
# {
#   "data": {
#     "status": "...",            ← 문서 상태
#     "grand_total": ...,         ← 화면에서 입력했던 최종 값
#     "outstanding_amount": ...   ← 실제로 기록된 값
#   }
# }
#
# 채점기는 이 data 필드의 값과 과제 정답 값을 대조해요.
# 화면에 성공 확인이 떠도 여기 값이 틀리면 실패로 판정돼요.
조용한 실패: 화면 성공과 DB 기록의 간극
이번 벤치마크의 핵심 발견은 ‘조용한 실패’예요. ERP에서는 화면에 성공 확인이 떴는데 DB에 값이 안 들어가거나 예전 값이 남는 일이 생겨요. 이 오류는 화면 어디에도 나타나지 않고, 재무·재고 같은 하류 프로세스로 그대로 전파돼요. 극단적 사례가 UI-TARS-7B예요. 목표 레코드 도달 95%, 저장 발동 68%인데 DB 정답률은 9%였어요. 저장을 눌렀는데 거의 다 잘못된 값이 들어간 거예요. T2 과제에서는 커밋 85%에 DB 정답 3%로, 간극이 더 벌어졌어요.
전체적인 낙차도 커요. Claude Sonnet 4.6은 T1 94%, T2/T3 100%로 인간 기준선(전문가 99~100%, 첫 사용자 87~96%)에 근접했어요. 반면 오픈 모델 중 최고 성적은 T1 34%, T2/T3 0~3%였고, 첫 사용자조차 모든 오픈 모델을 크게 앞섰어요. 도메인 지식 부족이 아니라 실행 능력의 차이라는 해석이에요. 모델별 주요 수치를 화면 쪽 지표와 DB 최종 채점으로 나눠 정리하면 아래와 같아요.
| 모델·구분 | 화면·조작 단계 지표 | DB 정답률(최종 채점) | 함께 볼 조건 |
|---|---|---|---|
| Claude Sonnet 4.6 | 인간 기준선에 근접 | T1 94%, T2/T3 100% | T3에서 런당 입력 토큰 약 2.0M(T1은 231K) |
| 오픈 모델 최고 | 해당 없음(최종 채점 기준) | T1 34%, T2/T3 0~3% | 첫 사용자(87~96%)에게도 크게 뒤짐 |
| UI-TARS-7B (T1) | 레코드 도달 95% · 저장 발동 68% | 9% | 저장했는데 대부분 잘못된 값 |
| UI-TARS-7B (T2) | 커밋 85% | 3% | 커밋 성공과 기록 성공의 간극이 가장 큰 사례 |
무너지는 지점은 모델마다 다르다
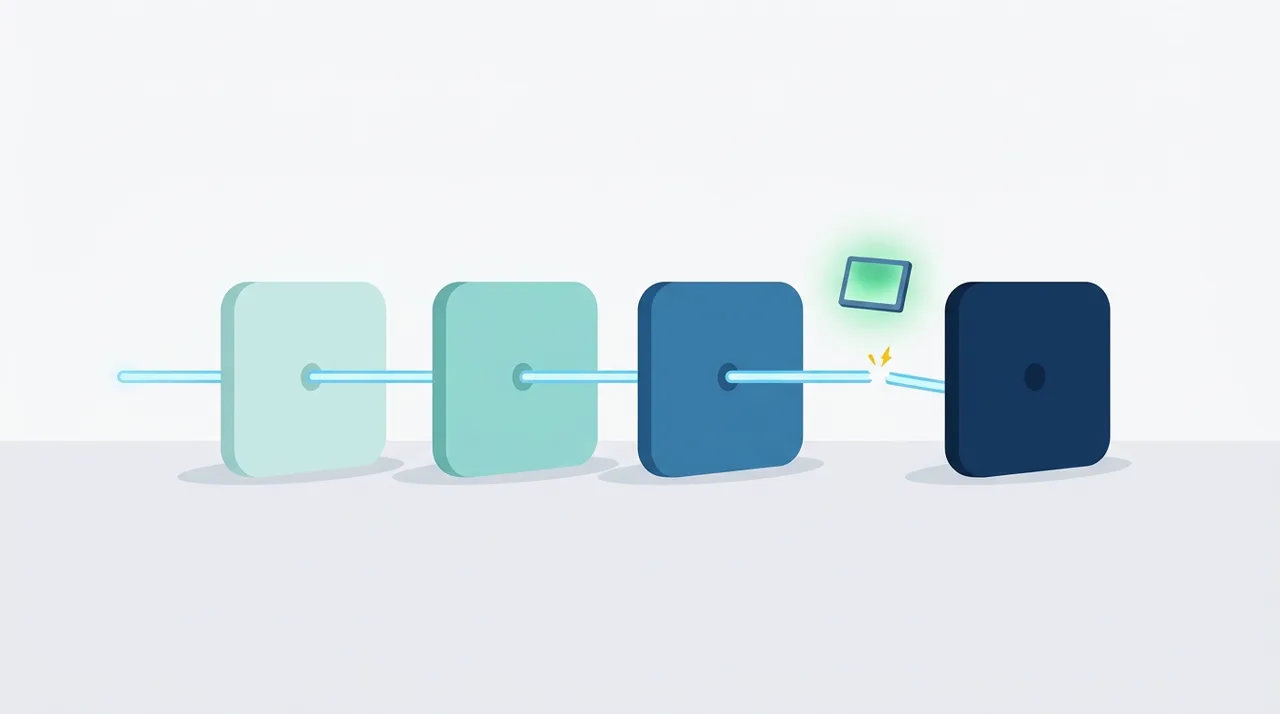
ERPBench의 방법론적 기여는 Navigation → Interaction → Commit → Database 4단계 채점으로 실패 지점을 분리한 거예요. 단계별로 쪼개니 화면에서는 멀쩡해 보이던 수행이 어느 단계에서 무너지는지 보여요. 흥미로운 건 모델마다 무너지는 지점이 다르다는 점이에요. Qwen3-VL-32B는 화면의 목표 버튼·입력창을 정확히 짚는 Grounding 실패가 59%로 주됐고, UI-TARS-7B는 저장했는데 DB에 잘못된 값이 기록되는 Perception 59%가 주됐어요.
성공 판정을 4단계로 나눠 어디서 무너졌는지 분리하고, 마지막 Database 단계에서만 잡히는 조용한 실패를 보여 줘요.
위험한 행동은 사람 승인으로 게이팅한다
벤치마크와 함께 하네스 설계도 공개됐어요. 각 턴마다 에이전트가 액션과 리스크 등급(safe/commit/irreversible)을 제안하면, 배포 모드에서는 사람이 승인해야 실행되고 commit·irreversible 액션은 항상 명시적 확인이 필요해요. 평가 모드에서만 자동 승인으로 무인 실행해요. 블로그 필자는 이 구조를 업무 시스템에 CUA를 붙이는 실무 결론까지 끌어갔어요.
화면 조작 능력은 엔터프라이즈 신뢰성을 보장하지 않음. 검증을 결과 상태에서 하고 위험 액션을 게이팅하는 하네스 없이는 CUA를 업무 시스템에 붙이면 안 된다는 게 이 벤치마크의 실무 결론임.
코난쌤 블로그, 2026-09-18 게시 · 2026-09-19 확인
같은 방향을 이미 돌려 본 공개 평가 환경
‘성공을 상태에서 채점한다’는 설계가 실제로 쓸 만한지는 공개 구현에서 힌트를 얻을 수 있어요. 관찰 범위에서 ERPBench 자체의 후속 활용 사례는 아직 찾지 못했지만, 같은 방향(스크린샷만 보는 에이전트 + ERPNext + Frappe REST 기반 최종 상태 채점)을 독립적으로 구현해 공개한 평가 환경이 하나 있었어요. 개발자 Varun Iyer가 공개한 cua-bench는 ERPNext 회계 과제에서 에이전트가 만든 최종 장부 상태를 채점기가 읽어 점수를 매기고, 화면 기록(트랜스크립트) 채점이 ‘일하는 것처럼 보이는 것’을 보상한다는 문제를 정면으로 짚었어요. 2026-09-19 확인 기준 공개 저장소와 해설 글로 함께 검토할 수 있었어요. 단, 이는 ERPBench의 재현이 아니라 같은 설계 방향의 독립 사례라는 점은 구분해서 봐야 해요.
오늘의 배울 점과 다음 적용
Editor_K의 해석 · 이번 근거에서 배운 건 “검사 위치가 결과를 만든다”는 확인이에요. AI가 성공했다고 해도 결과물을 직접 확인한다는 초급 원칙에, 화면 성공 68~95% 대비 DB 정답률 3~9%라는 정량 근거가 붙었어요. 다음 실습에서는 자동화 과제 하나를 골라 (1) 저장·실행 뒤 화면 메시지가 아니라 결과 상태를 직접 열어 확인하기, (2) 값이 비어 있거나 예전 값이 남아 있으면 실패로 기록하기, (3) 삭제·전송처럼 되돌리기 어려운 행동은 실행 전 승인 단계를 두기를 연습해 볼 생각이에요. 중급 과정의 ‘AI 권한 설계’ 주제에서는 safe/commit/irreversible 등급 분리가 바로 설계 출발점이 돼요.
적용 전에는 세 가지를 확인해요. 첫째, 결과 상태 확인은 읽기 권한이 필요해요. 내가 쓴 자동화가 접근할 수 있는 범위와 내가 확인할 수 있는 범위를 먼저 구분해야 해요. 둘째, 이런 벤치마크의 인간급 성적은 높은 토큰 비용(런당 입력 토큰 약 2.0M)이 전제예요. 도입 판단에는 비용 계산이 함께 들어가야 해요. 셋째, 위험 액션 게이팅은 사람의 승인 절차를 전제로 해요. 승인 없는 무인 실행을 먼저 설계하지 않아요.
한계와 남은 질문
이 벤치마크는 30개 과제를 5회 반복한 소규모 평가이고, ERPNext 단일 시스템이라 다른 엔터프라이즈 소프트웨어로의 일반화는 열려 있어요. Claude의 인간급 성적도 런당 입력 토큰 약 2.0M 비용이 전제라, 도입 판단에는 별도의 총소유비용 계산이 필요해요. 수치는 블로그 정리와 논문 초록을 2026-09-19에 대조한 값이라, 과제 구성·모델 버전이 바뀌면 숫자도 달라질 수 있어요. “에이전트에게 시작 URL을 주는가” 같은 지시 조건이 성능 변수(체인 완성도 22%→9%)로 보고된 것도, 같은 모델이라도 실험 설계에 따라 결과가 달라질 수 있음을 보여 줘요.
출처와 시각자료
본문 출처
- 코난쌤, “저장을 눌렀는데 DB엔 틀린 값이 들어감 — 화면 검증이 못 잡는 ERP 조용한 실패를 잰 ERPBench” · 2026-09-18 게시, 2026-09-19 확인 (1차 근거, arXiv:2609.17885 병기)
- ERPBench: A State-Grounded Evaluation Paradigm for Computer-Use Agents in Enterprise Software (arXiv:2609.17885) · 2026-09-19 확인 (원 논문)
- Varun Iyer, cua-bench 공개 평가 환경 (GitHub) · 2026-09-19 확인 (초기 활용 관찰 — ERPBench 재현이 아닌 같은 설계 방향의 독립 사례)
시각자료 출처
- 대표 이미지를 포함한 본문 이미지 3장은 이미지 생성 도구로 2026-09-19에 생성한 AI 생성 이미지예요. 실제 제품 화면·문서 화면·인물을 재현하지 않은 개념 일러스트로 사용했어요.
- 모델별 수치 비교표와 4단계 채점 데이터 흐름 다이어그램은 Editor_K가 작성했어요. 근거는 위 코난쌤 블로그 정리와 논문(arXiv:2609.17885)이며, 다이어그램은 읽기 쉽게 재구성했어요.
forum 토론 및 피드백 0
아직 작성된 피드백이 없습니다. 첫 번째 생각을 남겨보세요!