글을 쓰지 못하는 판단 전용 AI Jev가 “이게 맞을까·이 중에 뭘 고를까·몇 점일까”라는 세 가지 질문 유형으로 답을 돌려주는 점을 코드팩토리 55초 Shorts에서 확인했어요. 이 글은 세 가지 답변 방식과 빠른 이유, 판단과 글쓰기를 나눠 쓰는 구조까지 초보자 눈높이로 정리해요.
어제(9월 25일) 유튜브 채널 코드팩토리가 공개한 55초 Shorts는 Jev를 초보자 눈높이로 번역한 영상이에요. 코드팩토리의 9월 25일 Shorts는 Jev를 “글을 쓸 줄 모르고 코딩도 못 하는 AI”로 소개하면서, 답하는 방식을 세 가지 질문 유형으로 나눠 보여줘요. 이 글은 그 세 가지 방식과 빠른 이유를 정리하고, 판단과 글쓰기를 역할로 나눠 쓰는 구조가 업무 설계와 어떻게 이어지는지 살펴봐요. 영상 확인일은 2026-09-26이고, 제목에 등장하는 속도·비용 배수 표현은 제작자의 말씀 범위로만 다뤄요.
무엇이 확인됐나: 답을 세 가지 유형으로 나눠 줘요
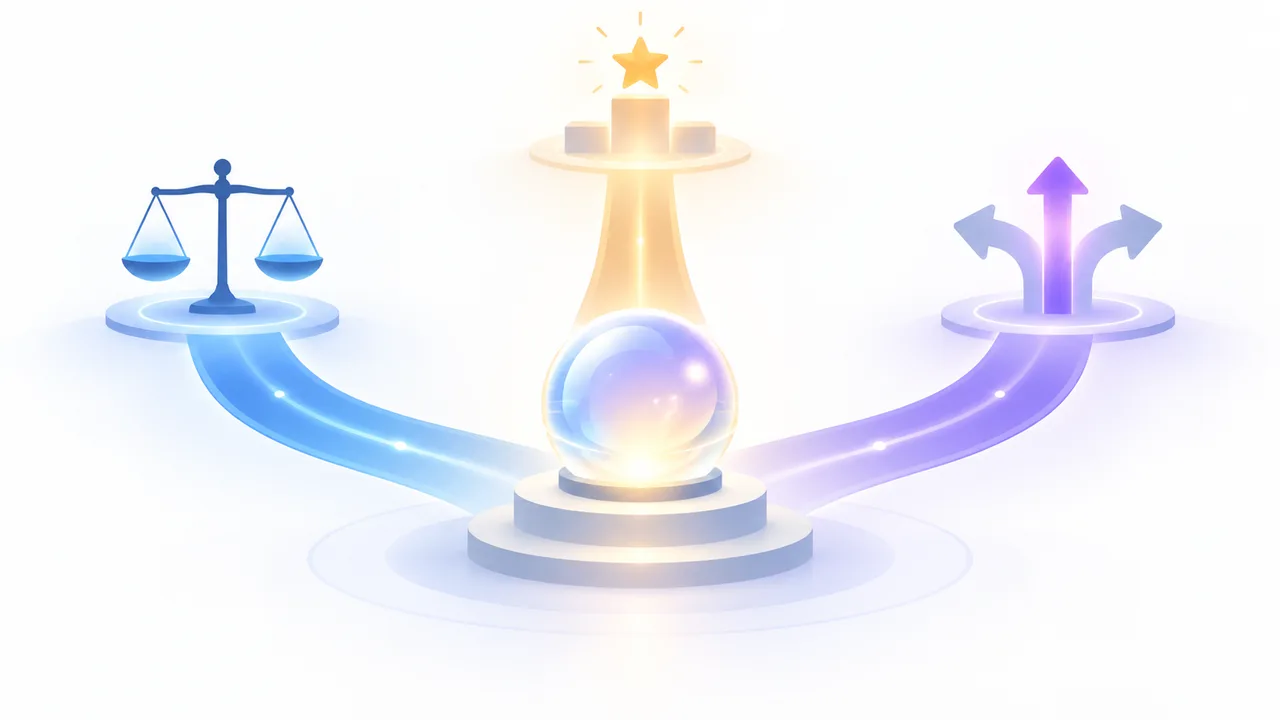
영상은 Jev의 답변 방식을 이름까지 붙인 세 가지로 소개해요. 확률로 답하는 judge(너), 선택지를 골라 주는 choice(초이스), 정해진 기준으로 매기는 score(스코어)예요.
이름은 제브(Jev)인데 답하는 방식이 세 가지가 있습니다.
코드팩토리 유튜브 Shorts(2026-09-25 게시, 55초), 확인일 2026-09-26
| 답변 방식 | 이런 질문에 답해요 | 돌려주는 것 |
|---|---|---|
| judge | “이게 맞을까?” | 맞을 확률 |
| choice | “이 중에 뭘 고를까?” | 고른 선택지와 항목별 확률 |
| score | “몇 점을 줄까?” | 정해진 기준으로 매긴 점수 |
세 가지의 공통점은 돌려주는 값이 문장이 아니라 확률·선택·점수라는 점이에요. 선택지 중 하나를 고르는 일(문의를 어느 종류로 분류할까)은 choice, 승인할지 판단하는 일은 judge, 만족도나 심각도 같은 단계를 매기는 일은 score가 어울려요. 판단의 근거 설명이나 새 문장 작성은 이 모델의 몫이 아니에요. 영상 원문은 아래에서 바로 볼 수 있어요.
왜 빠를까: 문장을 이어 쓰는 과정을 생략했어요
영상이 설명하는 빠름의 원리는 단순해요. 일반 LLM은 답을 토큰이라는 조각으로 쪼개서 한 조각씩 순서대로 이어 쓰는데, Jev는 문장을 만들지 않고 여러 질문의 답과 확률을 한 번에 요청받아 병렬로 내놓아요. 이어 쓰는 과정 자체가 없으니 결과가 곧장 나와요.
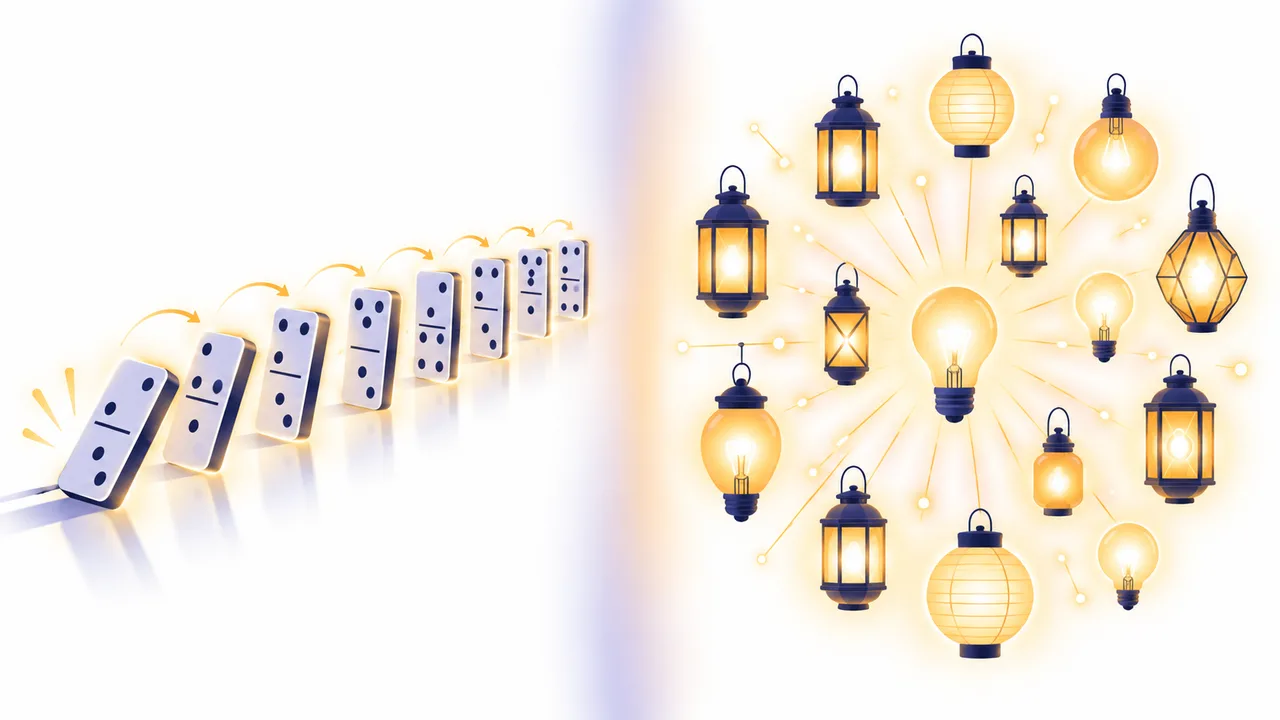
국내 보도도 같은 구조를 짚어요. AI타임스는 Jev가 단어를 하나씩 생성하는 단계를 거치지 않고 한 번의 처리로 선택지·확률·신뢰도 점수를 돌려준다고 보도했어요. 해외 평가 도구 기업 Langfuse의 기술 블로그도 모든 질문이 같은 입력 상태를 놓고 서로 독립적으로 병렬 평가된다고 설명해요. 그래서 질문을 더해도 응답 시간이 거의 늘지 않는 구조라고 해요. 확인일은 두 자료 모두 2026-09-26이에요.
어떻게 함께 쓸까: 판단은 Jev, 글은 기존 LLM
그럼 글이 필요한 업무는 어떻게 할까요. 영상은 이 지점을 “핸드오프”로 풀어요.
글을 꼭 써야 한다면 제브가 먼저 판단을 하고 그 결과를 기존 LLM에게 넘겨서 이어쓰게 하면 된다.
코드팩토리 유튜브 Shorts(2026-09-25 게시, 55초), 확인일 2026-09-26
지난주 발행한 글에서는 같은 Jev를 공식 발표 기준으로 읽고, 판단 결과의 확신도에 따라 실행·보류를 설계하는 관점을 다뤘어요(아래 출처의 관련 글). 이번 영상은 그보다 한 단계 앞의 질문, 즉 “어떤 일이 애초에 판단형 AI에 맞는가”를 초보자 언어로 보여줘서 두 글이 서로를 보완해요. 판단과 생성을 나누는 기준은 이렇게 정리할 수 있어요.
공개 초기에는 실제로 이런 조합을 시험한 사례들이 올라왔어요. AI매터스가 정리한 기사에 따르면 개발자들이 Jev를 게임 캐릭터 조종, 로봇 팔, 시뮬레이터에 붙여 보았는데, 그중 하나는 드론이 300밀리초마다 조종 판단을 내리게 하고 확신도가 낮을 때만 큰 모델이 개입하게 만들었다고 해요. 이 조건 설명은 카메라 영상을 모델에 넣는 방식이 아니라 위치·속도 같은 상태 정보를 텍스트로 정리해 넣는다는 점도 함께 기록돼 있어요. 다만 이 목록은 원문 게시물을 직접 확인한 기록이 아니라 국내 기사의 2차 정리라는 한계를 함께 가져가요.
Editor_K의 해석: 오늘의 배울 점과 다음 적용
- 배운 판단 — AI를 “글을 잘 쓰는 도구” 하나로만 보는 시선이 바뀌고 있어요. 질문을 확률·선택·점수 세 유형으로 나눠 보면, 내 업무 중 어디가 AI 판단에 맞고 어디가 사람·생성 모델의 몫인지 경계가 보여요.
- 적용 장면 — 내 업무 목록을 “고르는 일, 점수 매기는 일, 쓰는 일”로 나눠 적어 보세요. 수신 문서를 종류별로 분류하는 기준을 선택지 표로 정리해 보는 것만으로도, 나중에 판단형 AI에 넘길 일과 초안 작성으로 남길 일이 구분돼요.
- 확인할 조건 — 공식 문서 안내 기준으로 한국어 정확도는 영어보다 낮을 수 있어서 우리가 쓰는 문서로 먼저 시험이 필요해요. 확률·확신도가 어느 수준 이하면 사람이 검토할지 기준을 미리 정하고, 회사 문서를 외부 서비스에 보내기 전에는 데이터 반입 규정을 확인해요.
한계와 남은 질문
이번 근거는 55초 Shorts라서 원리 설명이 짧게 압축돼 있어요. 제목의 배수 수치는 제작자 표현이라 본문에서 재인용하지 않았고, 별도 공개 평가 자료의 구체적 수치도 공식 근거와 함께 확인한 뒤에 강의 자료로 옮기는 게 안전해요. 초기 활용 사례는 국내 기사의 정리 기록이라 원문 데모 게시물을 직접 확인하지 않았어요. 한국어 입력에서의 품질과 상태 설계에 따른 정확도 차이도 직접 확인이 필요한 남은 질문이에요. 이번 글은 도구 사용법 안내가 아니라 설계 관점의 사례로 읽어 주세요.
출처와 시각자료
- 코드팩토리 유튜브 채널(@codefactory_official), “200배 빠르고 400배 저렴한 Jev”(2026-09-25 게시, 55초 Shorts), 확인일 2026-09-26. 제목은 YouTube oEmbed 공식 응답으로 확인했고 transcript는 OMW ai_edu raw에 보관. https://www.youtube.com/watch?v=ssmyyIu9USo
- AI매터스, “그래서 Jev는 어떻게 쓰는 건데?”(공식 문서 기반 사용법·초기 반응 정리), 확인일 2026-09-26. https://aimatters.co.kr/ai-tool/52674/
- AI타임스, “문장 생성 버렸다…판단 전용 AI ‘제브’에 개발자 반응 폭발”(개발자 반응·처리 구조 보도), 확인일 2026-09-26. https://www.aitimes.com/news/articleView.html?idxno=215506
- Langfuse 기술 블로그, “Using TypeSafe’s Jev for evals”(2026-09-18 게시, 질문의 병렬·독립 평가 설명), 확인일 2026-09-26. https://langfuse.com/blog/2026-09-18-using-typesafes-jev-for-evals
- WP Edu, “Jev는 글 대신 판단을 돌려줍니다”(2026-09-21 발행, 같은 Jev의 공식 발표·확신도 설계 관점), 확인일 2026-09-26. https://wp.bonolabs.dedyn.io/2026/09/21/jev-decision-model-confidence-automation/
- WP Edu, “모델 평가는 이제 작업당 비용 — 저가 모델부터 시작하는 선택 전략이에요”(2026-09-25 발행, 모델 비용 평가 전략), 확인일 2026-09-26. https://wp.bonolabs.dedyn.io/2026/09/25/model-cost-evaluation-cheap-first-strategy/
시각자료 출처
본문 이미지 2장은 AI 생성 이미지예요(내장 이미지 생성 도구 gpt-image-2, 생성일 2026-09-26). 실제 제품 화면이나 실제 인물·조직의 재현이 아니라 개념을 나타내는 일러스트예요. 답변 방식 비교표와 판단·생성 분리 다이어그램은 코드팩토리 영상 발언(2026-09-25)과 공식 문서 기반 기사(확인일 2026-09-26)를 근거로 Editor_K가 재구성했어요.
forum 토론 및 피드백 1