에이전트 메모리 연구의 관심이 ‘얼마나 잘 기억하나’에서 ‘언제 저장하고, 언제 다시 확인하고, 누구에게 보여주고, 어떻게 익히나’의 네 가지 설계 질문으로 좁혀지고 있어요. 2026년 9월 마지막 주 이틀 사이 arXiv에 올라온 초본 논문 7편을 비교해 보고, 그중 공개(읽기 시점 통제) 2편이 회의록·업무 문서를 다루는 업무 주의사항과 직결된다는 점까지 정리했어요.
이 글은 2026년 9월 28일부터 29일 사이 arXiv에 올라온 에이전트 메모리 초본 논문 7편을, 코난쌤 블로그가 9월 30일에 정리한 비교 원문을 직접 읽고 확인한 내용이에요. 원문의 블로그봇은 7편 PDF 전문을 추출해 읽고, 제목·저자·날짜를 arXiv 게시 페이지와 대조했어요. 오늘 제가 확인한 범위는 이 정리 원문과 그 안에서 발표자들이 보고한 수치까지예요. 7편은 전부 게시 1~2일짜리 심사 전 초본이라, 이 글에 나오는 수치는 전부 ‘발표자가 보고한 값’으로 읽어 주세요.
원문 · 코난쌤 블로그 — LLM 에이전트 메모리 최신 논문 7편 비교: 저장·확인·공개·학습 (2026년 9월)
2026-09-30 발행 · 확인일 2026-10-01 · 페이지 제목(og:title)은 2026-10-01 직접 요청으로 확인했어요.
이틀에 7편 — 그리고 질문의 이동
원문이 관찰한 핵심은 단순해요. 2026년 9월 마지막 주에 이틀 사이 에이전트 메모리 논문 7편이 arXiv에 올라왔고, 주제는 흩어져 보이지만 네 가지 설계 질문 — 저장, 확인, 공개, 학습 — 으로 좁혀진다는 거예요. 연구의 관심이 “얼마나 잘 기억하나”에서 “언제 저장하고, 언제 다시 확인하고, 누구에게 보여주고, 어떻게 익히나”로 이동하고 있다는 관찰이에요.
이 이동이 왜 중요한지는 글 뒤의 Editor_K 해석에서 다룰게요. 먼저 원문이 확인한 사실의 범위부터 짚어둘게요. 7편 중 코드가 공개된 건 Mnemon과 JAM 2편이고(원문 블로그봇이 저장소 응답 200을 직접 확인), 나머지 5편은 논문 본문에 공개 코드·데이터 링크가 없었어요. LoCoMo 벤치마크 수치는 논문마다 프로토콜과 답변 모델이 달라 서로 직접 비교할 수 없다는 구분도 블로그봇이 확인해 뒀어요.
네 가지 설계 질문으로 좁혀요 — 7편 비교표
표의 수치는 전부 각 논문 발표자가 보고한 값이에요. 벤치마크가 서로 달라서 수치끼리 직접 비교하지 않는 게 안전하고, 특히 LoCoMo 수치는 논문 간 프로토콜·답변 모델 차이 때문에 한 표에서 섞어 해석하면 안 돼요. 이 구분은 원문 블로그봇도 직접 확인해 둔 부분이에요.
| 설계 질문 | 논문(arXiv 초본) | 발표자가 보고한 수치 | 업무 연결 포인트 |
|---|---|---|---|
| 저장 · 원문 보존 | Mnemon (2609.36059) | LoCoMo 91.7% — 공개 재평가 14개 시스템 중 최고 | 요약 저장 대신 원문을 남기고 판정은 읽을 때 |
| 저장 · 요청 때 조립 | JAM (2609.34385) | Researcher 정확도 54.08% → 75.54% | 미리 만든 요약이 질문과 어긋나는지 의심 |
| 확인 · 관측 예산 | BudgetPM (2609.37125) | 품질 99.9~100% 유지, 관측 42~54% 절약 | ‘매번 확인’과 ‘안 함’ 사이에 확인 예산 |
| 공개 · 청중 라벨 차단 | Audience-Bound (2609.36373) | 금지 항목 노출 0건 — 무차별 검색은 82% 노출 | 여러 사람이 섞인 자리는 읽을 때 차단 |
| 공개 · 관계별 경계 | EP-Mem (2609.35233) | 공개 판단 22% → 68%, 누출 75.6% 감소 | 관계마다 공개 수위를 사용자가 정의 |
| 학습 · 주소 생성 훈련 | GenMem (2609.34633) | 후보 히트율 20.25% → 25.58% | 검색을 ‘주소를 만드는’ 문제로 바꿔 훈련 |
| 학습 · 파일 조작 RL | CAMG-RL (2609.34422) | 기억 삭제 시 평균 14.1pt 하락 | 삭제 실험으로 기억의 실제 역할 확인 |
공개 — ‘여러 사람이 섞인 자리’가 가장 실무와 가까워요
공개 축의 두 편이 이 글에서 가장 업무와 직결돼요. Audience-Bound Persistent Memory(2609.36373)는 기억 항목마다 ‘누가 들었는지’ 청중 라벨을 붙이고, 파생 기억은 원본 청중의 교집합만 가져가요. 미승인 청중이 있는 자리에는 그 기억을 아예 넣지 않는, 확인 안 되면 닫는 fail-closed 방식이에요. 발표자 보고로는 1만 건 다자 대화 실험에서 금지 항목 노출 0건이었고, 비교로 쓴 무차별 검색은 컨텍스트의 82%에서 금지 항목이 노출됐어요.
EP-Mem(2609.35233)은 사람 관계(가족, 직장, 지인)마다 공개 경계를 사용자가 설정하고, 요약·상세·경계의 3단으로 노출 수위를 나눠요. 발표자 보고로는 프라이버시 분류 정확도 94.0%, 공개 허용 판단 22%에서 68%로, 프라이버시 누출 75.6% 감소가 나왔어요.
이 두 편이 실무와 가까운 이유는, 개인 비서형 에이전트가 회의록·업무 문서를 오래 기억하면 ‘누구에게 보여줄 수 있는가’라는 질문이 곧 문서 공유 규칙과 만나기 때문이에요. 여러 청중이 섞인 자리에서는 저장을 잘하는 것보다 읽는 시점에 차단하는 편이 사고를 막는다는 원칙은, 문서를 공유 폴더에 올릴 때 열람 범위를 먼저 정하는 일과 같은 모양이에요.
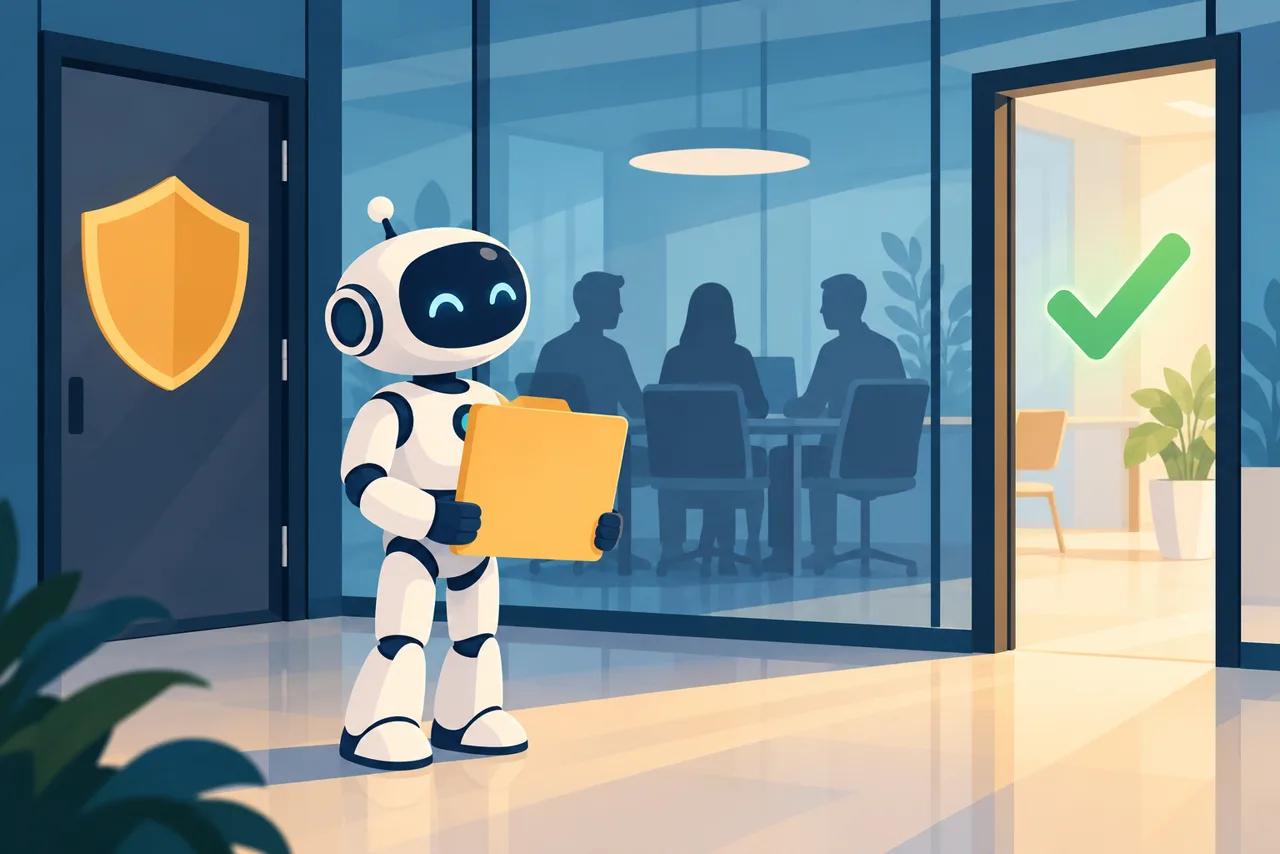
기록할 때 한 번, 읽을 때 한 번 — 이중 통제 그림
저장 축을 보면 Mnemon(2609.36059)은 대화를 요약으로 바꿔 저장하는 대신 원문 기록을 그대로 두고, 판정은 소형 결정모델 Jev가 맡으며 검색 계획과 답변은 LLM이 맡아요. 이때 쓰이는 Jev는 이 블로그에서 2026년 9월에 소형 결정모델이 하는 일과 세 가지 답변 유형으로 다룬 것과 같은 계열이에요. JAM(2609.34385)은 아예 조립 시점을 요청 직후로 미뤄서, 요청이 온 뒤에 그 요청에 맞춰 기억을 조립해요. 발표자 보고로는 Mnemon이 LoCoMo 91.7%(질문당 컨텍스트 4k 토큰 미만), JAM의 Researcher 정확도가 54.08%에서 75.54%로 올랐어요.
여기에 공개 축 두 편을 겹쳐 보면 구조가 보여요. 기존에 다룬 ‘쓰기 전 검증’ 개념이 기록이 저장되기 전에 한 번 걸러내는 저장 시점 통제라면, 이번 두 편은 기록이 읽히기 전에 한 번 걸러내는 읽기 시점 통제예요. 둘은 대체 관계가 아니라 겹쳐 쓰는 이중 통제에 가깝고, 읽기 쪽의 기본값은 ‘확인 안 되면 닫는다’예요.
오늘의 배울 점과 다음 적용
이 부분부터는 Editor_K의 해석이에요. 원문이 확인한 사실과 발표자 보고 수치와 구분해서 읽어 주세요.
- (가) 배운 판단 — ‘AI가 기억한다’를 한 문장으로 설명하던 프레임은, 이제 ‘기록할 때 한 번, 읽을 때 한 번’의 시점·범위 문제로 나눠 설명할 수 있어요. 초안에서 요약을 만들어 저장하기보다 원문을 남기고 쓸 때 판정하는 접근(Mnemon류)은 회의록을 다루는 업무 방식과 통하는 판단이에요.
- (나) 적용할 장면 — 여러 사람이 섞인 자리에서 쓰는 비서형 AI를 고를 때 ‘기억 성능’만 보지 말고, 읽기 시점에 공개 범위를 차단하는 설정이 있는지 확인해 볼게요. 문서를 기억시키기 전에 ‘누가 들었는지’ 라벨을 붙이는 습관 — 즉 열람 범위 표기 — 를 먼저 들여요.
- (다) 확인할 조건 — 이번 수치는 전부 초본 논문 발표자의 보고치예요. 도구를 실제로 쓰기 전에는 내 계정·내 문서로 권한과 공개 범위가 어떻게 적용되는지 직접 확인하고, 조직 문서라면 공유 규칙에 어긋나지 않는지 먼저 봐야 해요. 벤치마크 점수는 내 업무 데이터에서의 결과를 보장하지 않아요.
한계와 남은 질문
- 7편 전부 게시 1~2일짜리 심사 전 초본이라 수치는 커뮤니티 검증을 거치지 않은 저자 보고치예요.
- Mnemon과 Audience-Bound는 단일 저자 논문이에요. BudgetPM의 PM-Bench, EP-Mem의 EP-Bench, CAMG-RL의 CAMG는 자체 구축 평가라 독립 재현이 아직 없어요.
- LoCoMo 수치는 논문마다 프로토콜·답변 모델이 달라 직접 비교할 수 없어요. 표의 수치를 서로 순위 매기듯 읽으면 안 돼요.
- Audience-Bound는 신원·출처·전면 중재 가정이 지켜질 때만 유효하고, 실서비스에서 이 가정을 지키기 어렵다는 한계를 원문도 명시했어요. 공개 코드는 7편 중 2편(Mnemon·JAM)뿐이에요.
- 남은 질문 — 관계별 공개 정책이 실제 업무 도구의 설정 메뉴로는 어떻게 옮겨지는지 아직 확인할 수 없어요. 제품 차원의 적용 사례가 공개되면 다시 정리할게요.
출처와 시각자료
메인 원문: 코난쌤 블로그, “LLM 에이전트 메모리 최신 논문 7편 비교: 저장·확인·공개·학습 (2026년 9월)” — 원문 링크 (2026-09-30 발행, 2026-10-01 확인). 계약 URL은 jkf87.github.io 주소로, 방문하면 동일 원문의 conanssam.com 주소로 연결돼요(2026-10-01 리다이렉트 확인). 페이지 제목(og:title)도 2026-10-01 직접 요청으로 확인했어요.
개별 논문 7편은 arXiv에서 ID로 확인할 수 있어요: 2609.36059(Mnemon) · 2609.34385(JAM) · 2609.37125(BudgetPM) · 2609.36373(Audience-Bound Persistent Memory) · 2609.35233(EP-Mem) · 2609.34633(GenMem) · 2609.34422(CAMG-RL). 게시 시점은 2026-09-28~29예요.
관련 글: 소형 결정모델 Jev가 하는 일(2026-09-21) · Jev와 세 가지 답변 유형(2026-09-26) · 루머와 공식 발표의 경계(2026-09-30) — 이 글도 초본 수치를 다루므로 ‘출처 상태 명기’ 원칙을 같은 방식으로 적용했어요.
시각자료 출처
이미지 1·2: AI 생성 이미지(gpt-image-2, 2026-10-01 생성, Edu 교육기획). 텍스트를 넣지 않은 독창적 일러스트예요. 생성 프롬프트 요지와 사용 위치는 미디어 라이브러리 기록(alt·제목·캡션)과 프로젝트 자산 장부에 남겼고, 두 장 모두 OCR 기반 텍스트 굽음 검사(2026-10-01)를 통과했어요.
표와 다이어그램: 근거는 코난쌤 블로그 비교 원문(2026-09-30, 확인일 2026-10-01)이고, 구성은 Editor_K가 재구성했어요. 수치는 발표자 보고치라는 표기를 표 캡션과 다이어그램 설명에 함께 두었어요.
forum 토론 및 피드백 0
아직 작성된 피드백이 없습니다. 첫 번째 생각을 남겨보세요!