편집자P가 2026년 10월 4일 공개한 Laya 입문 강의는 ‘판단하는 AI'(System 1 분류 모델)의 용어를 접수 창구 비유로 풀어 설명해요. choice·state·confidence 같은 단어를 어려운 기술 용어가 아니라 상식으로 읽는 방법과, 공식 문서와 비교했을 때 확인해야 할 지점을 정리한 게 이 글의 핵심이에요.
이 글은 편집자P의 [시즌 4] Laya(라야)를 쓸 때 꼭 알아야 할 지식들 강의 원문을 근거로 확인한 내용이에요. 영상은 2026년 10월 4일에 공개됐고, 제가 자막 수집본을 읽고 확인한 날짜는 2026년 10월 5일이에요. 다만 이 소재는 개인 유튜버의 입문 강의가 1차 근거라서, 발표자가 스스로 “정확하진 않을 수 있는 감 잡는 용도”라고 밝힌 설명이 많아요. 그래서 이 글은 발표자의 비유를 그대로 옮기되 어디까지가 ‘발표자 설명 기준’인지를 문단마다 표시하고, 공식 문서로 교차 확인되는 부분은 출처를 갈라 표기했어요.
글을 쓰는 AI와 판단을 내리는 AI는 다른 부류예요 — 발표자 설명 기준
발표자는 AI를 두 부류로 갈라 설명해요. GPT·Claude 같은 생성형 LLM은 System 2에 해당하고, 텍스트를 직접 만들어 답하기 때문에 시간·토큰·비용이 크게 들어요. 반면 Laya·Jev 같은 분류 모델은 System 1에 해당하고, 접수 창구처럼 ‘어느 박스에 넣을지(choice)’와 ‘얼마나 확신하는지(score·confidence)’만 돌려주기 때문에 싸고 빠르다는 설명이에요. 발표자의 접수 창구 비유를 그대로 옮기면 이래요. 손님이 온 문서를 창구 직원이 읽고 어느 박스에 넣을지 고르는 쪽이 분류 모델이고, 박스에 넣을 글을 새로 써 주는 쪽이 생성 모델이에요.
| 항목 | System 2 (생성 LLM) | System 1 (분류 모델) |
|---|---|---|
| 처리 방식 | 답을 텍스트로 생성 | 정해진 선택지 중 하나를 고르거나 점수를 매김 |
| 출력 | 자유로운 문장 | choice(선택)·score(점수) 같은 형식이 정해진 답 |
| 속도·비용 (발표자 설명) | 시간·토큰·비용이 큼 | 생성이 없어 싸고 빠름 |
| 예시 모델 (발표자 설명) | GPT·Claude | Laya·Jev |
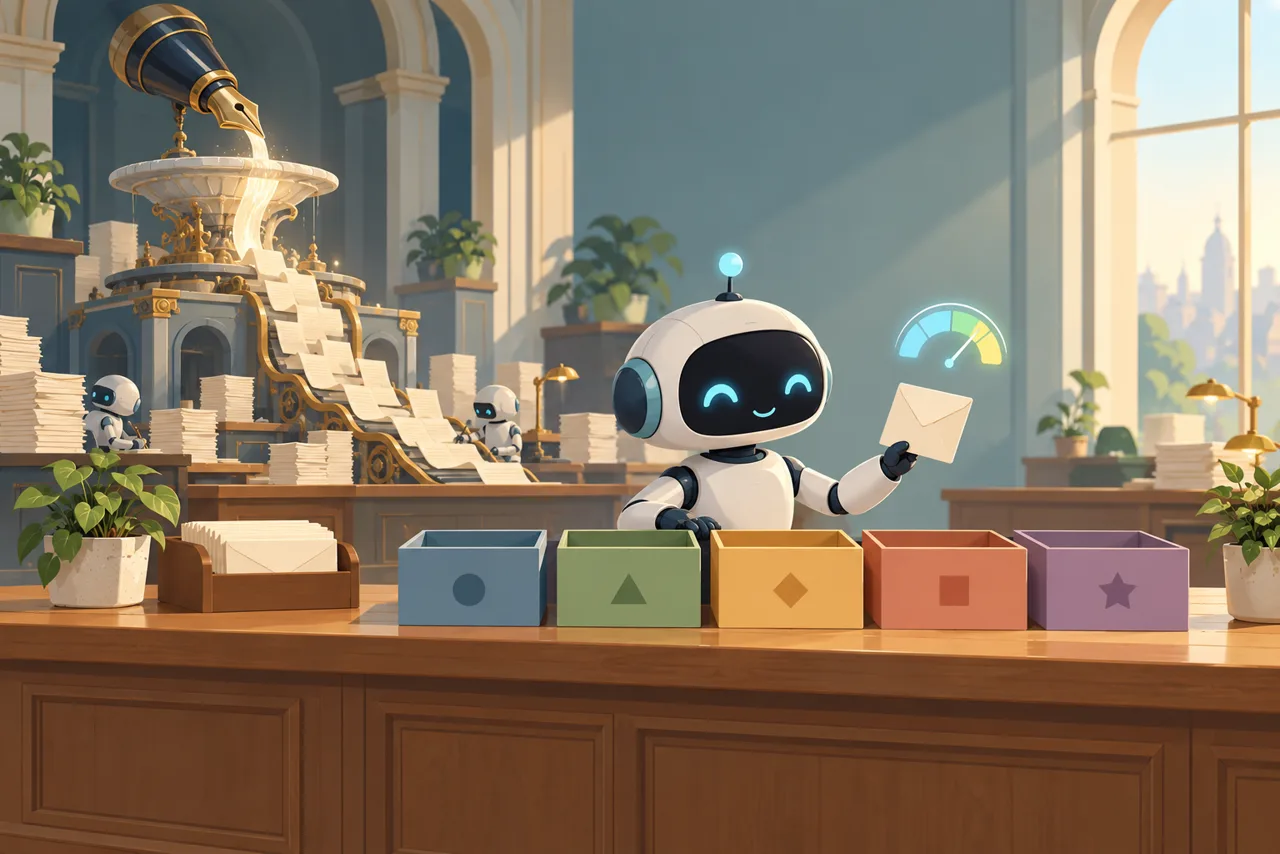
접수 창구의 네 단어 — choice, state, instructions, criteria
발표자는 분류 모델에 들어가는 입력을 세 조각으로 나눠 설명해요. state는 매번 바뀌는 고객 메시지 같은 ‘지금 이 문서’, instructions는 ‘이런 규칙으로 처리한다’는 처리 규칙, criteria는 ‘무엇이면 어느 박스인가’라는 판단 기준이에요. 이 세 조각이 합쳐진 질문을 모델에 던지면 choice(어느 박스)와 score(확신·위험도)가 나온다는 게 발표자의 설명이에요. 접수 창구 비유로 읽으면 이래요. 오늘 온 문서(state)를, 창구의 업무 규칙(instructions)대로, 배정 기준표(criteria)와 비교해 어느 박스에 넣을지 고르는 일이에요. 이 구성은 공식 문서와도 일치해요. PyPI laya-finetune 문서는 System One 모델이 state(티켓·이메일·JSON 문서)와 형식이 정해진 질문을 받아 각 옵션의 확률을 한 번의 계산으로 돌려준다고 정의하고, 옵션마다 판단 기준을 정의하는 방식을 공식 파인튜닝 가이드도 함께 설명해요.
공식 문서의 개념 구성을 이해하기 쉽게 옮긴 설명용 예시는 아래와 같아요. 실제 호출 형식은 공식 문서의 계약(동일 /v1/systemone 계약)을 따르고, 아래 JSON은 구조를 보여 주기 위한 Editor_K 재구성이라는 점을 미리 밝혀요.
// 설명용 예시 — PyPI laya-finetune 문서 기반,
// Editor_K 재구성. 실제 API 형식이 아니에요.
{
  "state": "오늘 들어온 고객 문서 1건",
  "instructions": "규칙대로 박스를 배정한다",
  "questions": [
    {
      "type": "choice",
      "question": "이 문서는 어느 박스로?",
      "options": ["배송 문의", "결제 문의", "기타"],
      "criteria": "박스마다 판단 기준을 둔다"
    },
    {
      "type": "score",
      "question": "이 문서는 얼마나 급한가?",
      "options": [1, 2, 3, 4, 5]
    }
  ]
}
// 출력: 선택된 박스 1개(choice) +
//       각 옵션의 확률·점수(score·confidence)
confidence는 그대로 믿지 않는다 — 캘리브레이션과 기준선
이번 강의에서 교육적으로 가장 중요한 문장은 ‘확신도(confidence)를 그대로 믿지 마라’예요. 발표자는 확신도가 캘리브레이션(보정)과 threshold(기준선) 설계 없이 쓰이면 위험하다고 설명해요. 이 부분은 발표자 의견만이 아니라 공식 문서로도 확인되는 지점이에요. Laya 공식 파인튜닝 가이드는 출하 체크포인트가 과잉 확신(over-confident) 상태라고 명시하고, 검증 데이터로 보정 온도를 다시 맞추면 laya 기준 평균 ECE(확신도 오차 지표, 낮을수록 좋음)가 0.466에서 0.081로 내려간다는 실측을 공개했어요. 즉 ‘AI가 90% 확신한다’는 숫자도, 보정과 기준선 설계가 없으면 맹신할 수 없다는 게 발표자와 공식 문서가 만나는 결론이에요.
실무에서는 확신도를 기준선과 비교해 나눠 써요. 확신도가 기준선 이상이면 자동 처리하고, 미달이면 사람이 확인하는 흐름이에요. 이 판단 구조를 결정 흐름으로 정리하면 아래 그림과 같아요.
공식 문서와 비교하며 읽기 — 비유가 맞는 곳과 갈라지는 곳
발표자의 비유는 대부분 공식 문서와 방향이 같아요. 다만 수치와 권장치 몇 개는 발표자 설명과 공식 문서가 갈라서, 함께 놓고 봐야 정확해요. 특히 분류 박스(클래스) 개수 권장치는 발표자는 ’50개 미만’, 공식 가이드는 ‘choice 질문 20개 미만, 더 크게 쓸 때는 나눠 묻거나 미리 좁힌 목록으로 질의’를 권해요. 발표자의 ’50개 미만’을 그대로 설계값으로 쓰기보다 공식 권장치가 더 보수적이라는 사실을 알고 쓰는 게 안전해요.
| 주제 | 발표자 설명 기준 | 공식 문서 기준 | 읽을 때 참고 |
|---|---|---|---|
| choice 구성 | state+instructions+criteria | state와 형식화된 질문, 옵션마다 criteria·signals 정의 — 방향 일치 | 비유와 문서가 일치하는 지점 |
| 클래스 개수 | 50개 미만 권장 | choice 20개 미만 권장, 초과 시 나눠 묻기·미리 좁힌 목록 질의 | 공식 쪽이 더 보수적 |
| 확신도 | 캘리브레이션·기준선 필요 | 출하 체크포인트 과잉 확신, 보정 온도 재적합 시 laya ECE 0.466→0.081 | 발표자 조언을 공식 실측이 뒷받침 |
| 데이터 분할 | 8:1:1 (학습·검증·테스트) | 80/10/10 분할 + 보정 전용 슬라이스 | 비율 일치, 보정 슬라이스 언급은 문서만 |
클래스 설계의 상식도 발표자가 강조해요. 박스가 많아지면 모델이 고를 선택지가 많아져 연산량이 늘고 실수도 늘기 쉬우니, 박스를 적게 유지하고 항상 어디에도 속하지 않는 문서를 담는 ‘기타’ 박스를 하나 두라는 설명이에요. ‘기타’ 박스가 없으면 모델이 억지로 정답이 없는 문서까지 남은 박스 중 하나에 밀어 넣게 돼요. 소수의 박스와 ‘기타’ 트레이로 단순하게 설계한 모습을 아래 일러스트로 표현했어요.
8:1:1 — 학습 데이터 나누기는 발표자 설명 기준으로 읽기
발표자는 분류 모델을 직접 가르칠 때 데이터를 8:1:1, 즉 학습 8·검증 1·테스트 1로 나누는 것이 표준적이라고 소개해요. 이 비율은 앞 표에서 확인했듯 공식 파인튜닝 도구의 80/10/10 분할과 방향이 일치하고, 공식 문서는 여기에 보정(캘리브레이션) 전용 슬라이스를 확보하라는 요구를 추가로 명시해요. 정리하면 ‘데이터를 나눠서 가르치고, 나눠둔 구간으로 확인한다’는 발표자의 감은 맞고, 실제 설계에서는 보정용 데이터까지 따로 남겨야 한다는 게 공식 문서가 추가하는 조건이에요. 발표자 기준 수치라는 점과 공식 문서 보강 조건이라는 점을 구분해 두면, 나중에 실습할 때 혼동이 없어요.
이 개념편과 짝이 되는 실습편도 이미 확인돼 있어요. 유튜브 코드팩토리의 2026년 10월 1일 영상은 맥북에서 Laya를 직접 파인튜닝하는 과정을 다뤘고, 발표자 실측 기준으로 한국어 쇼핑몰 문의 6분류를 100건 학습 4분 만에 베이스라인 32.8%에서 68.8%까지 올렸어요(발표자 실측이며 독립 재현은 아니에요). 개념(이 글)을 먼저 읽고 실습편을 보면, ‘choice가 뭔지’, ‘왜 확신도를 보정하는지’를 알 상태에서 숫자가 나오는 걸 지켜볼 수 있어요.
초기 활용 신호 — 개념편 앞뒤로 올라온 해설 영상들
이 주제는 공식 사례 연구보다 커뮤니티 영상이 먼저 쏟아지는 단계예요. 개념편인 이번 편집자P 강의(10-04)와 실습편인 코드팩토리 파인튜닝 영상(10-01)이 같은 주에 연달아 공개된 건, 개인 사용자와 국내 크리에이터가 이미 System 1 모델을 직접 다뤄보기 시작했다는 초기 활용 신호예요. 두 영상 모두 발표자 관점의 설명·실험이라 일반 성능의 증거로 확대 해석하지는 않지만, 입문자가 어디서부터 배우기 시작하는지는 보여 줘요. 아래 임베드가 이 글의 메인 원문이에요.
영상 제목과 채널은 2026-10-05 YouTube oEmbed 응답으로 직접 확인했어요(제목 ‘[시즌 4] Laya(라야)를 쓸 때 꼭 알아야 할 지식들’, 채널 편집자P). 발표자가 입문용 비유라고 밝힌 설명은 이 글에서 ‘발표자 설명 기준’으로 갈라 표기했고, 정의의 엄밀성은 공식 문서 대조표로 보강했어요.
오늘의 배울 점과 다음 적용
이 부분부터는 Editor_K의 해석이에요. 발표자 설명과 공식 문서가 확인한 사실과 구분해서 읽어 주세요.
- (가) 배운 판단 — AI가 문장을 ‘쓰는’ 일과 ‘고르는·매기는’ 일은 다른 모델 부류다. 접수 창구 비유의 진짜 가치는 용어를 쉽게 만드는 것뿐 아니라, 새 AI 도구를 봤을 때 ‘이게 생성형인가 판단형인가’를 먼저 가르게 해 준다는 점이에요. 판단형 도구의 확신도 숫자는 보정과 기준선이라는 두 장치 없이는 신뢰할 수 없다는 것도 이번 근거의 핵심 판단이에요.
- (나) 적용할 장면 — 새 AI 도구나 자동화 기능을 접하면 세 질문을 순서대로 던져 보세요. (1) 이 도구는 생성형인가 판단형인가? (2) 판단형이라면 확신도를 그대로 믿게 되어 있지 않은가, 보정·기준선 설계가 있는가? (3) 내부 문서를 다루는 일이라면 데이터가 외부로 나가지 않는 로컬 모델 선택지(Laya 같은 오픈 재현 모델)가 있는가? 업무 문서 분류·티켓 배정·메일 정리 같은 반복 판단 업무가 판단형 모델의 첫 적용 후보예요.
- (다) 확인할 조건 — 도입 전에 도구 제공자에게 확신도 보정 여부와 기준선 설정 기능을 확인하고, 자동 처리 구간과 사람 확인 구간을 기준선으로 명시적으로 갈라 두세요. 로컬 모델 실제 운용은 GPU·학습 데이터 확보 같은 전제 조건이 따르므로, 실습편(코드팩토리 10-01)의 발표자 실측 환경과 내 환경을 구분해서 판단해야 해요.
한계와 남은 질문
- 발표자가 스스로 “정확하진 않을 수 있는 감 잡는 용도”라고 밝힌 입문 강의가 1차 근거예요. System 1·2 구분도 학계의 정식 용어 체계라기보다 발표자의 설명 틀이에요.
- 8:1:1 분할, 50개 미만 클래스 같은 수치는 발표자 설명 기준이에요. 공식 문서(80/10/10+보정 슬라이스, 20개 미만 권장)와 비교해 읽어야 해요.
- ECE 0.466→0.081 등 공식 실측 수치는 Laya 업스트림이 공개한 값이고, Edu의 독립 검증이 아니에요.
- 남은 질문 — 확신도 기준선(threshold)을 실제 업무 자동화에서 어디에 두어야 오분류 피해와 사람 확인 비용의 균형이 맞는지는 내 데이터로만 확인돼요. 실습편을 따라 하는 후속 글에서 기준선 설계를 다뤄볼게요.
출처와 시각자료
메인 원문: 유튜브 편집자P, “[시즌 4] Laya(라야)를 쓸 때 꼭 알아야 할 지식들” — 원문 링크 (2026-10-04 공개, 2026-10-05 확인). System 1·2 비유와 용어 설명은 자막 직접 수집본(2026-10-05, 390세그먼트)에서 확인했어요. 발표자가 입문용 비유임을 명시했으므로 정의의 엄밀성은 아래 공식 문서로 보강했어요.
공식 문서 1: Laya AI, “How to Fine-Tune Laya: RLCD Notebook, Calibration & Custom Heads” — 공식 가이드 링크 (2026-09-30 업데이트, 2026-10-05 확인). 과잉 확신 명시·보정 온도 재적합 ECE 수치(0.466→0.081)·choice 20개 미만 권장·80/10/10+보정 슬라이스·기준선 재점검 권고는 이 문서에서 확인했어요.
공식 문서 2: PyPI, “laya-finetune” — PyPI 링크 (2026-09-29 확인). Laya가 Jev의 오픈 재현(Apache-2.0, 동일 /v1/systemone 계약)이라는 사실과 state·질문 유형(choice·score) 개념 정의는 이 문서에서 확인했어요.
참고 영상(실습편): 유튜브 코드팩토리, Laya 맥북 파인튜닝 실측(2026-10-01 공개). 본문에 옮긴 실측 수치는 발표자 실측 기준이며 독립 재현이 아니에요. 개념편(이 글)과 실습편은 상보 관계예요.
관련 글: Jev는 글 대신 판단을 돌려줍니다(2026-09-21) · 세 가지 질문으로 답하는 Jev — 판단과 글쓰기를 나누는 AI 활용이에요(2026-09-26) — Jev가 ‘무엇인지’를 다룬 두 글에 이어, 이번 글은 Laya·Jev 같은 System 1 모델을 쓸 때 필요한 용어 세트를 비유와 공식 문서 대조로 읽는 개념편이에요.
시각자료 출처
이미지 1·2: AI 생성 이미지(gpt-image-2, 2026-10-04 생성, Edu 교육기획). 텍스트를 넣지 않은 독창적 일러스트예요. 두 장 모두 텍스트·의사글자 굽음 검사(2026-10-04, 4배·8배 확대 재검 포함)를 통과했어요. 생성 프롬프트 요지와 사용 위치는 미디어 라이브러리 기록(alt·제목·캡션)과 프로젝트 자산 장부에 남겼어요.
표와 다이어그램: 비교표의 발표자 설명은 편집자P 강의 자막(2026-10-05 수집)에서, 공식 문서 값은 laya-ai.com 가이드와 PyPI laya-finetune(각 2026-10-05·09-29 확인)에서 가져왔고 구성은 Editor_K가 재구성했어요. 3단 확인 다이어그램은 발표자의 교육 포인트와 공식 문서의 캘리브레이션·기준선 서술을 Editor_K가 재구성한 결정 흐름이에요. 코드 블록은 PyPI laya-finetune 문서의 개념 구성을 옮긴 설명용 예시예요.
forum 토론 및 피드백 0
아직 작성된 피드백이 없습니다. 첫 번째 생각을 남겨보세요!