“두 묶음이 둘 다 평균 5면 같은 데이터일까?”라는 질문으로 시작하는 3분짜리 초급 통계 강의를 관찰한 기록이에요. 평균·중앙값·최빈값 중 대표값을 고르는 기준과 분산·표준편차·IQR로 ‘퍼짐’을 읽는 법, 비율 변화에 기하평균을 쓰는 이유까지 정리했어요.
보고서에 “평균적으로는 이렇습니다”라는 문장이 하나 있으면 데이터 읽기는 끝난 것처럼 보여요. 그런데 제로초(ZeroCho TV)의 데이터과학 4편 영상(2026-10-15 게시, 2분 58초, 무료 공개)은 평균 숫자 하나가 같아도 데이터 전체가 같지는 않다는 반직관부터 시작해요. 이 글은 개인 유튜버의 초급 통계 강의 영상을 1차 근거로 삼은 강의 콘텐츠 관찰 + 개념 해설 기록이에요. 공식 발표 소식이 아니라서 “출시·공개”류 소식 톤이 아니에요. 원문은 유튜브 영상 ‘데이터과학 4편 – 평균이 같은데, 왜 전혀 다른 데이터일까?’에서 볼 수 있어요. 이 글의 예시와 수치는 전부 영상에서 확인한 내용이고, Edu의 해석은 별도 문단으로 구분해서 적었어요.
평균 5 두 묶음은 같은 데이터일까요
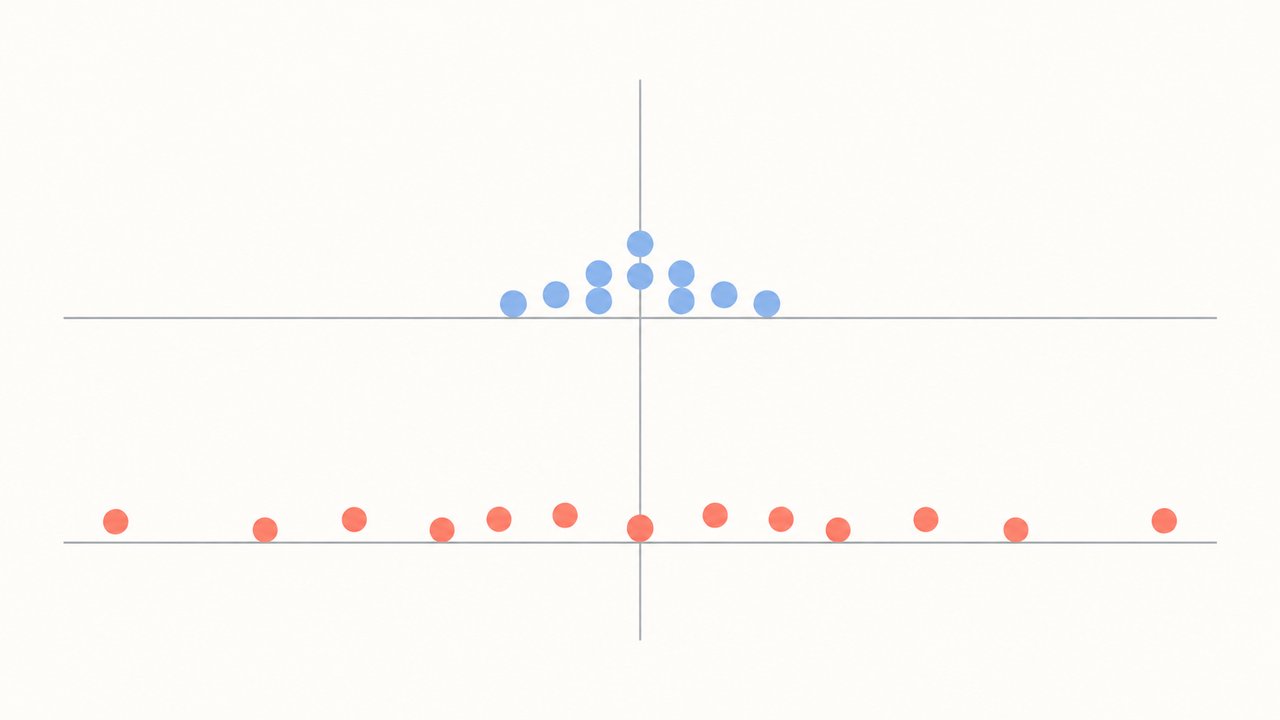
영상은 두 개의 묶음을 보여 주면서 시작해요. “두 개의 묶음이 있어요. 둘 다 평균이 5거든요. 그러면 a와 b는 같은 데이터라고 볼 수 있을까요?” — 영상의 도입 질문이에요. 한쪽은 가운데에 촘촘하게 모여 있고, 다른 쪽은 양쪽으로 넓게 퍼져 있어도 평균은 똑같이 5가 나올 수 있어요. 평균이 같다고 데이터까지 같지 않다는 게 이 강의의 첫 메시지예요. 평균 하나만 적은 보고서에는 이 차이가 전부 사라져요.
평균은 큰 값 하나에 휘둘려요
평균의 약점도 영상의 설명 그대로예요. “평균이라는 거는 큰 값 하나에 쉽게 휘둘릴 수가 있어요”라고 발표자는 짚어요. 영상의 예시를 따라 4, 5, 6의 평균을 계산하면 5예요. 여기에 큰 값 100이 하나 끼어들면 평균은 28.75로 뛰어올라요. 그런데 가운데 값은 5.5에서 5.5로 거의 그대로예요. 이때는 평균 대신 가운데 값, 즉 중앙값(median)이 더 나은 대표값이 된다는 설명이에요.
대표값은 평균·중앙값만이 아니에요. “가장 많이 나온 그 숫자를 대표값으로 생각해도 돼. 요걸 이제 최빈값 모드라고 그럽니다” — 영상은 최빈값(mode)도 대표값 후보로 소개해요. 그리고 어떤 대표값을 고를지는 데이터를 보고 정하는 문제이고, 셋 각각 장단점이 있다는 점도 영상에서 확인했어요.
| 대표값 | 이런 데이터에 어울려요 | 기억할 약점 |
|---|---|---|
| 평균 | 튀는 값이 없이 고르게 퍼진 데이터 | 큰 값 하나에 쉽게 휘둘려요 |
| 중앙값 | 큰 값이나 작은 값이 끼어 있을 때 | 흩어진 정도는 알려 주지 않아요 |
| 최빈값 | 특정 값이 유독 많이 나올 때 | 유일하지 않을 수 있어요 |
분산은 왜 제곱하고, 표준편차는 왜 루트를 쓸까요
여기서부터가 이 강의의 백미예요. 공식을 암기시키는 게 아니라 ‘왜’를 유도하는 순서로 설명해요. 데이터마다 평균과의 차이(편차)를 구해서 더하면 어떻게 될까요. 평균보다 큰 쪽 차이와 작은 쪽 차이가 서로 상쇄돼서 “다시 다 0이 돼 버리거든요” — 그래서 부호를 없애려고 제곱을 하는 거고, 제곱해서 더한 뒤 개수로 나눈 값이 분산이라는 흐름이에요.
그렇다면 표준편차의 루트는 왜 붙일까요. 영상의 답은 단위 문제예요. “제곱cm랑 cm랑 단위가 다르잖아요. 그렇기 때문에 루트로 맞춰 주는 거예요” — 원래 데이터와 같은 단위로 돌려놓는 절차라는 거예요. 표준편차가 크다는 말은 데이터가 더 퍼져 있다는 뜻이에요. 평균 5 두 묶음이 다른 데이터인 이유가 바로 이 ‘퍼짐’의 차이예요.
IQR과 상자수염그림으로 퍼짐을 그려요
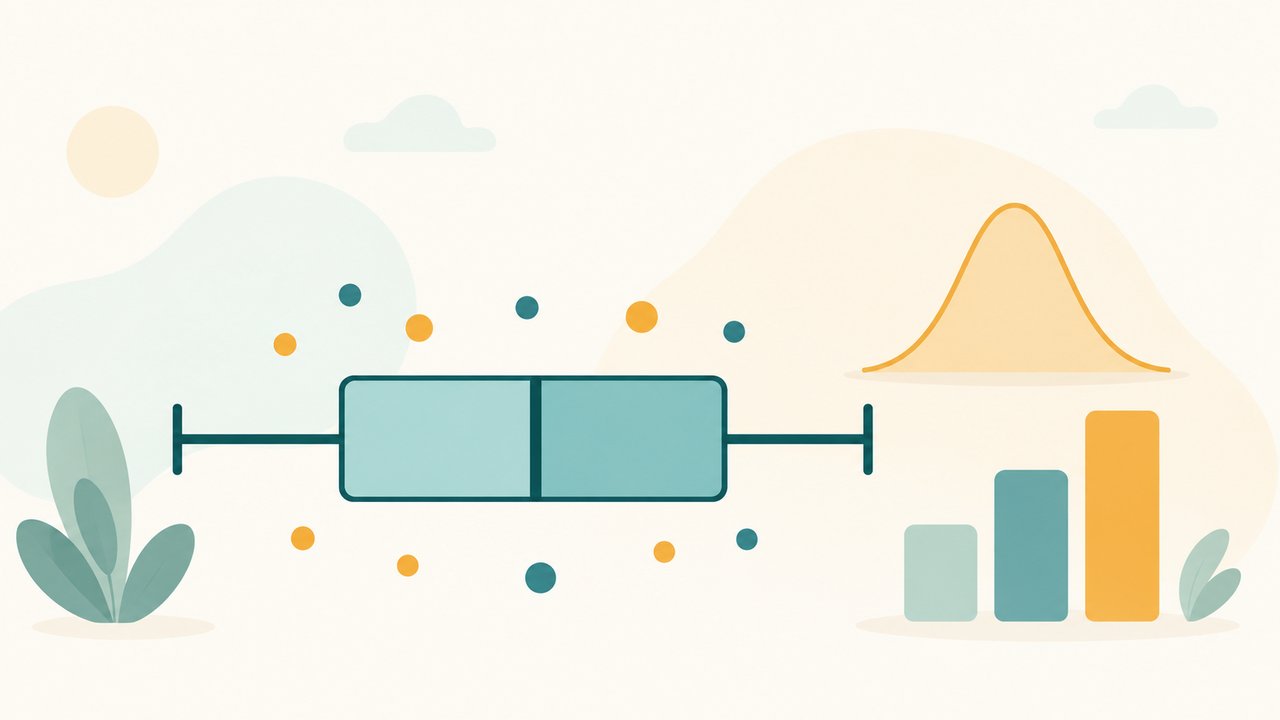
퍼짐을 읽는 두 번째 도구는 IQR이에요. 앞 시리즈 3편에서 다룬 그 IQR이 이번에는 시각화와 함께 돌아와요. “IQR 저희 사용했던 거 사용해서 데이터를 또 표현할 수도 있어요” — 하위 25%와 상위 25% 경계 사이 간격으로 퍼짐을 표현하고, 이것을 상자수염그림으로 그릴 수 있다는 설명이에요. 상자의 양쪽 수염은 최소값과 최대값, 상자 가운데 선은 중앙값을 나타내요. 순서가 있는 데이터는 상자수염그림 대신 선 그래프로 표시하는 것이 중요하다는 안내도 이어졌어요.
퍼센트 변화의 평균은 기하평균으로
마지막 개념은 기하평균이에요. “기하 평균은 곱한 다음에 루트로 나누는 거예요. 퍼센티지로 움직이는 경우에는 보통 기하 평균을 많이 내요” — 영상의 설명이에요. 2배 올랐다가 0.5배 내려온 데이터의 평균 변화를 산술 평균으로 계산하면 1.25배가 되지만, 실제로는 곱셈 2 × 0.5의 루트인 1배, 즉 제자리예요. 비율로 움직이는 데이터는 이렇게 곱한 뒤 루트를 씌우는 기하평균으로 평균 변화를 잡아요. 그리고 “데이터들이 막 곱셈 배율 관계로 늘어난다 하면 보통 로그를 많이 취해서 데이터를 분석을 해요”라는 안내로 끝나요.
발표자의 3분 설명은 아래 영상에서 그대로 확인할 수 있어요.
평균·중앙값·최빈값 중 데이터 성격에 맞게 고른다. 큰 값에 휘둘리는 평균만 고집하지 않는다.
편차의 제곱 평균(분산)과 단위를 되돌린 루트(표준편차), 상자 25~75% 간격(IQR)으로 흩어짐을 읽는다.
퍼짐은 상자수염그림(수염=최소·최대, 중앙=중앙값), 순서가 있는 데이터는 선 그래프로 표시한다.
퍼센트·배율 변화는 곱한 뒤 루트를 씌우고, 배율 관계 데이터는 로그를 취해 분석한다.
교실에서 이 강의를 어떻게 쓸까요
여기부터는 Editor_K의 해석이에요. 첫째, 이 영상은 엑셀·보고서의 ‘평균만 제시하는 습관’을 점검하는 데이터 리터러시 소재로 적합해요. 같은 주제로 시리즈 3편(빈칸은 0이 아니다 — 누락값·이상값, 2026-10-11 발행)을 다뤘는데, 3편이 ‘값을 어떻게 정리할까’였다면 4편은 ‘정리한 값을 어떻게 요약할까’의 축이에요. 두 편을 한 세션에 붙이면 데이터 정리 흐름이 자연스럽게 이어져요.
둘째, 공식 암기가 아니라 이유 단계로 개념을 유도하는 설명법을 그대로 배울 만해요. 분산을 “편차를 더하면 0이 되니까 제곱한다”, 표준편차를 “제곱cm를 cm로 되돌리는 단위 정리”로 풀어 주는 방식은, 대표님이 선호하시는 작은 시연 → 원리 확인 흐름과 맞닿아 있어요. 수업에서도 공식을 먼저 주지 말고 “왜 제곱해야 할까요”를 학습자에게 던지는 순서로 재구성할 수 있어요.
셋째, 3분 안에 대표값 3종·분산·IQR·기하평균까지 다루는 밀도는 초보자에게는 부담일 수 있어요. 수업에서는 중심(대표값)과 퍼짐(분산·IQR)까지만 다루고, 기하평균은 비율 데이터 사례가 필요할 때 별도로 꺼내는 편이 좋겠어요.
오늘의 배울 점과 다음 적용
이 아래도 Editor_K의 해석으로, 영상 설명과 구분해서 읽어 주세요. 오늘 남는 판단은 두 가지예요. (가) 요약 보고서의 평균 하나는 ‘중심 선택 + 퍼짐 표시’가 함께 가야 완성이고, (나) 퍼센트 변화의 평균은 기하평균으로 잡는다는 점이에요. 다음 적용 장면은 익숙한 스프레드시트예요. 평균을 적을 때 표준편차나 IQR을 한 칸 옆에 붙이고, 증감률 평균을 낼 때는 산술 평균 대신 곱셈 관계를 확인하는 습관이 확인 조건이에요.
한계와 남은 질문
이 글의 근거는 3분 분량의 개인 강의 영상과 자막 발췌예요. 공식 통계 교재가 아니라서 용어·기호 선택은 발표자의 강의 방식을 따랐고, 수치 예시도 영상에서 확인한 범위(평균 5 두 묶음, 4·5·6에서 평균 28.75·중앙값 5.5, 2배 후 0.5배)로 제한했어요. 구체 분산 계산 연습이나 통계 소프트웨어 사용법은 다루지 않았어요. 남은 질문은 두 가지예요. 업무 보고서에서 ‘평균 + 퍼짐’을 함께 요약하는 표준 양식을 어떻게 둘지, 그리고 기하평균을 실무 증감률 보고에 어디까지 적용할지는 다음 글감으로 이어가 볼 만해요. 시리즈 2편(데이터 타입 4분류)·3편(누락값·이상값)과 개념은 이어지지만 학습 내용이 달라서, 본 글은 4편 기준으로만 썼어요.
출처와 시각자료
- 영상 원문: 제로초(ZeroCho TV), ‘데이터과학 4편 – 평균이 같은데, 왜 전혀 다른 데이터일까?’, 2026-10-15 게시, 2분 58초, 무료 공개. https://www.youtube.com/watch?v=HlX6GYt0UcI (2026-10-16 oEmbed·자막 확인) — 개인 유튜버의 초급 통계 강의 영상으로, 이 글의 1차 근거예요.
- 발표자 발화 기록: 위 영상의 유튜브 자막 수집본(118세그먼트, 2026-10-16 수집, OMW ai_edu raw 보존). 이 글의 인용 구분 기준으로 삼았어요.
- 시리즈 맥락: 같은 블로그의 데이터 정리 시리즈 3편 — 빈칸은 0이 아니다 — 누락값·이상값 다루기(2026-10-11 발행). IQR 첫 소개는 이 글을 참고하세요.
시각자료 출처
- 첫 번째 이미지: AI 생성 이미지(gpt-image-2, 2026-10-16 생성, Edu 제작). 텍스트 없는 독창적 일러스트이며 실제 산점도가 아니에요.
- 두 번째 이미지: AI 생성 이미지(gpt-image-2, 2026-10-16 생성, Edu 제작). 텍스트 없는 독창적 일러스트이며 실제 상자수염그림이 아니에요.
- 대표값 비교 표·퍼짐 읽기 도식: Edu Editor_K가 발표자 설명(2026-10-15 영상, 2026-10-16 자막 확인)을 재구성해 만든 것이에요.
- YouTube 임베드: 원문 공식 임베드예요.
근거 수준 고지: 이 글의 사실 관계는 개인 강의 영상 확인 시점(2026-10-16) 기준이며, Edu의 독립적 재검증이 아니라 영상 내용의 관찰·요약이에요. 이후 영상이 수정·삭제되면 인용 부호도 확인이 필요해요.
forum 토론 및 피드백 0
아직 작성된 피드백이 없습니다. 첫 번째 생각을 남겨보세요!